Infometis Software Automation & AI Day 2026

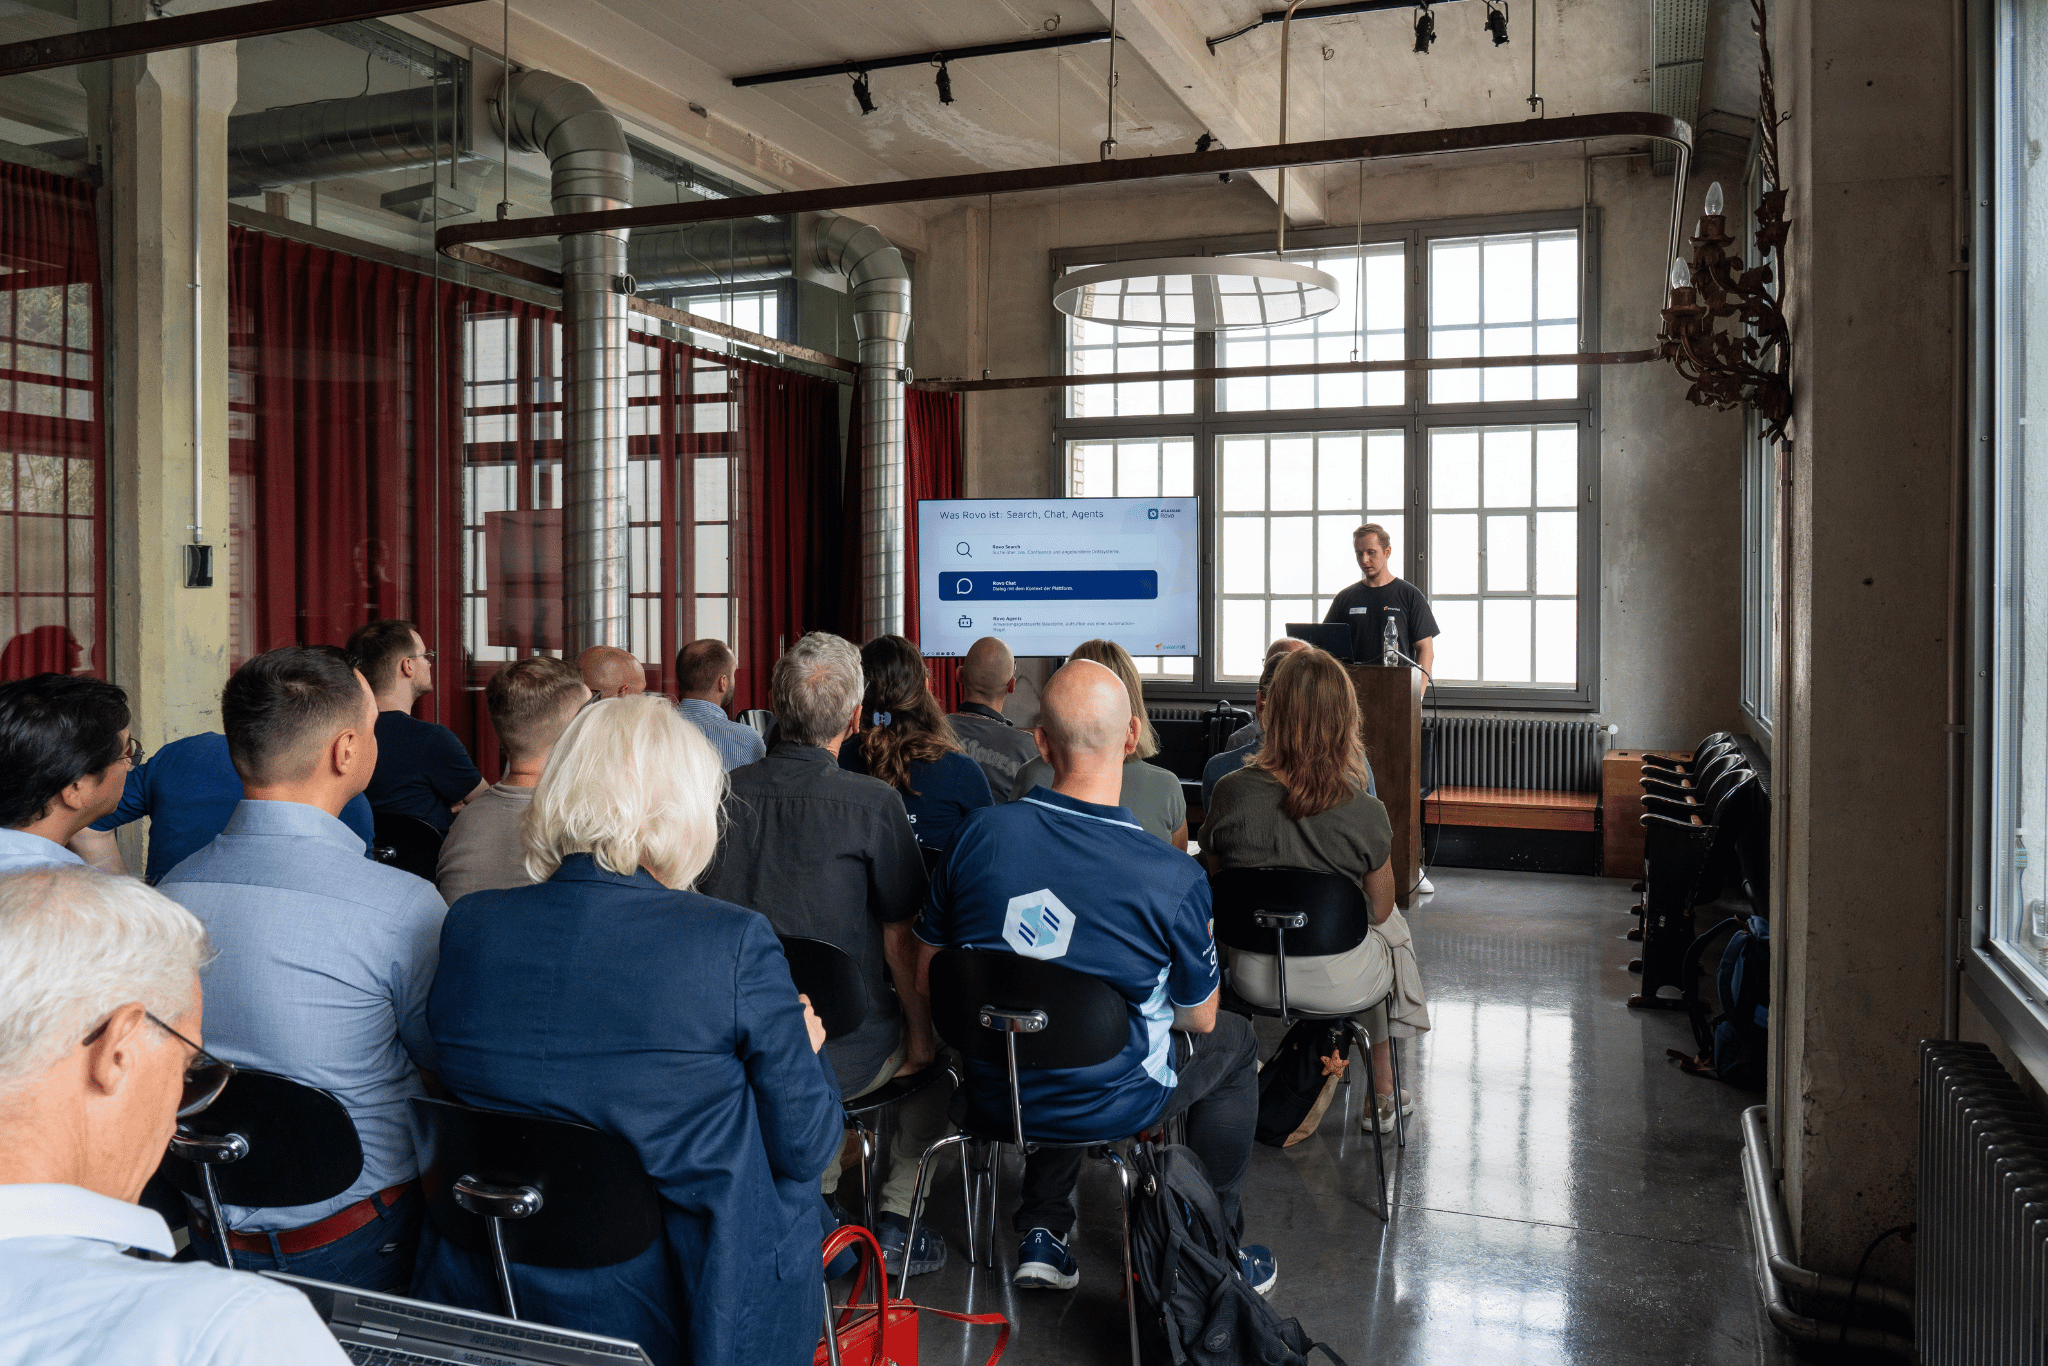
Rückblick auf unsere Rovo-Demo am Automation & AI Day
Nach unserem Vortrag am AI Automation Day kamen die meisten Fragen zu einem Thema, das in der Demo gar nicht vorkam: Wohin gehen die Ticketdaten, wenn Rovo sie liest? Das sagt viel über das Publikum. Wer in einer Bank, einer Versicherung oder der Verwaltung arbeitet, fragt zuerst nach den Daten und erst danach nach dem Nutzen. Diese Reihenfolge ist richtig. Hier fassen wir zusammen, was wir gezeigt haben, was wir daraus mitnehmen und wie die Antworten auf die wichtigsten Fragen lauten.
Was wir gezeigt haben
Neue Tickets in Jira Service Management landen zuerst im Status «AI Triage». Ein Rovo Agent liest die Beschreibung und setzt strukturierte Felder: Impact, Urgency, Kategorie, betroffene Applikation und einen Vertrauensscore von 0 bis 100. Danach übernimmt eine Jira-Automation das Routing. Ab einem Score von 70 geht das Ticket direkt in die passende Team-Queue, darunter bleibt es zur manuellen Prüfung stehen.
Die Arbeitsteilung ist bewusst gewählt. Rovo übernimmt die semantische Einordnung, die Automation das deterministische Routing. Damit bleibt nachvollziehbar, warum ein Ticket wo gelandet ist: Die Begründung des Agents steht als Kommentar im Ticket.
Was wir mitnehmen
- Klassifikation funktioniert, wenn der Text die Belege liefert. Beim klaren Fall, Oracle CRM lädt seit dem Morgen keine Kundenakten mehr und das ganze Vertriebsteam ist betroffen, hat der Agent jedes Feld korrekt gesetzt und die passenden Textstellen als Begründung zitiert. Das ist der eigentliche Mehrwert: Die KI erkennt Zusammenhänge in Freitext, die sich mit Regeln kaum abbilden lassen.
- Der Vertrauensscore ist das schwächste Glied. In unseren Testläufen lag der Score fast immer zwischen 85 und 95. Ein Score, den das Modell über sich selbst ausgibt, bleibt eine Selbsteinschätzung. Er ist ein brauchbares Signal, als alleinige Routing-Grundlage reicht er nicht.
- Deshalb messen wir die Korrekturquote. Die AI Correction Rate zeigt, wie oft Mitarbeitende im Service Desk ein von der KI gesetztes Feld nachträglich ändern. Sie misst im Nachhinein, was der Score vorher nur behauptet. Für uns ist sie die wichtigste Kennzahl eines solchen Setups, gefolgt von Time-to-Assignment und Reassignment-Rate.
Die Fragen aus dem Publikum
Wo werden die Daten verarbeitet?
Rovo gibt es ausschliesslich in Atlassian Cloud. Rovo-Daten lassen sich derzeit in dieselbe Region pinnen wie die Jira- oder Confluence-Daten, bei einer Schweizer Instanz also Zürich. Data Residency regelt dabei den Speicherort. Welche Drittanbieter an der Verarbeitung der Anfragen beteiligt sind, zeigt die Sub-Processor-Liste von Atlassian. Für regulierte Organisationen gehört dieser Abgleich zur Vorabklärung.
Trainieren die KI-Anbieter mit unseren Tickets?
Bei den externen Sprachmodellen lautet die Antwort nein. Atlassian hält fest, dass Kundendaten nie an Drittanbieter weitergegeben werden, um deren Modelle zu trainieren oder zu verbessern, und dass diese Partner unter Zero-Data-Retention-Vereinbarungen arbeiten.
Anders sieht es bei Atlassian selbst aus, und dieser Punkt ist neu. Seit dem 17. August 2026 verwendet Atlassian Metadaten und In-App-Daten, um Apps und KI-Funktionen für alle Kunden zu verbessern, gesteuert über neue Einstellungen zur Data Contribution. Die Standardwerte hängen vom Plan ab. Bei Premium sind Metadaten standardmässig aktiv und In-App-Daten deaktiviert, und die Beteiligung an Metadaten abschalten können nur Organisationen mit Enterprise-Plan. Ausgenommen sind Organisationen mit HIPAA-Anforderungen sowie bestimmte Behörden und Finanzdienstleister. Unsere Empfehlung: Die Einstellung unter Atlassian Administration › Security › Data contribution jetzt prüfen und den Entscheid dokumentieren.
Ist nachvollziehbar, was die KI entschieden hat?
Auf Ticketebene ja: In unserem Aufbau schreibt der Agent jede Einordnung mit Score und Begründung als Kommentar ins Ticket. Zusätzlich erfasst das Atlassian Audit Log Rovo-Aktionen. Rovo Admin Insights zeigt nur aggregierte Nutzungszahlen, einzelne Prompts bleiben privat. Wer Entscheidungen der KI prüfen will, braucht deshalb die Protokollierung im Prozess selbst.
Und wenn wir auf Data Center arbeiten?
Dann gibt es Rovo nicht im eigenen Betrieb. Rovo Connectors können Daten aus Data Center in die Cloud-Wissensbasis synchronisieren. Das verschiebt die Datenschutzfrage lediglich, statt sie zu lösen, und sollte entsprechend geprüft werden.
Wann sich AI Triage lohnt
AI Triage bringt am meisten, wo viele Tickets mit Freitext eingehen und das manuelle Zuweisen spürbar Zeit kostet. Bei wenigen, stark strukturierten Tickets erledigen gut gepflegte Formulare und Regeln dasselbe günstiger. Wer den Einsatz erwägt, sollte die Datenschutzfragen vor dem ersten Prompt klären.
Genau dabei unterstützen wir: von der Vorabklärung zu Data Residency und Data Contribution über den Aufbau des Rovo Agents bis zur Messung der Korrekturquote im laufenden Betrieb. Brian Trepto, der die Demo gezeigt hat, beantwortet deine Fragen gerne direkt: Kontakt aufnehmen
Die Präsentation mit allen Folien zur Demo kannst du hier herunterladen: Präsentation herunterladen